Mostrando entradas con la etiqueta cloud computing. Mostrar todas las entradas

miércoles, 3 de febrero de 2016

Recurriendo a los recursos para construir soluciones


Cuenta la leyenda que una vez la humanidad intentó colaborar para construir una torre que llegara al cielo. De igual modo los sistemas y aplicaciones se comunican y colaboran desde algún tiempo a través de distintos mecanismos para construir soluciones cada vez más elaboradas y poderosas.

Numerosas tecnologías han desfilado como soluciones a este planteamiento, desde llamadas a procedimiento remoto (RCP), CORBA, Java con RMI y más tarde con los Session Beans hasta protocolos como SOAP y servicios web que transportan información via HTTP.

La tendencia parece ser simplificar cada vez más los formatos de intercambio y exponer la información por medio de protocolos ligeros y estándar para facilitar la transmisión de datos a través de una red, así como el procesamiento de los datos una vez que llegan al dispositivo solicitante.

Hoy en día se escucha mucho de REST y la construcción de interfaces que permiten exponer datos y disparar acciones a manera de servicios desde aplicaciones de terceros.

Algunos casos de uso de un REST API son:
  • Integración de sistemas.
  • Automatización de tareas.
  • Backend para aplicaciones móviles
  • Generación de aplicaciones reactivas (Que amerita su propia entrada de blog inspirada por Freya)
En el siguiente vínculo hay una descripción ámplia, precisa y hasta matemática de los conceptos que tienen que ver con REST.


De igual modo se intentará sintetizar el conocimiento surgido de quebrarse la cabeza (otros objetos alrederor y por poco algunos cráneos) al implementar soluciones y así resaltar algunos puntos relevantes de la forma más pragmática posible.

Entre recursos y otras artes oscuras

Recurso es el concepto clave en REST, el cual es una abstracción de información identificada por un nombre. Ej: Un documento o imágen, una colección de otros recursos, una persona, un servicio, etc.

Los recursos REST son accesibles a través del protocolo HTTP a través de URL's, usando un método específico, como GET , POST , PATCH , PUT y DELETE . Cada método es una solicitud para realizar una operación en el recurso.
  • GET. Recupera un recurso 
  • POST. Genera un nuevo recurso a partir de los parámetros de la petición
  • PATCH. Realiza una actualización parcial en el recurso
  • PUT. Realiza una actualización total en el recurso
  • DELETE. Elimina el recurso
Algunos ejemplos de rutas estilo REST son:

Verbo HTTP Ruta Descripción
GET /orders Muestra una lista de órdenes
GET /orders/:id Muestra una órden específica
POST /orders Crea una nueva órden
PUT/PATCH /orders/:id Actualiza una órden específica
DELETE /orders/:id Elimina una órden específica
GET /orders/cancelled Recupera una lista de órdenes canceladas
GET /orders/:id/items Recupera los artículos de una órden específica
PATCH /orders/:id/send/Actualiza el estado de una órden específica e inicia el envío

Cabe señanar que el pensar "a la REST", permite organizar la estructura de una aplicación, ya sea un REST API o una aplicación web tradicional,  basándose en una convención dictada por la industria. Esto ayuda a evitar que los desarrolladores o arquitectos "creativos" definan estructuras que pueden llegar a ser muy complejas y difíciles de manterner.

Las 3D's del génesis

Los recursos que son accedidos o modificados son básicamente un conjunto de conceptos relativos a un problema de negocio específico. Cada concepto puede visualizarse como una entidad la cual está descrita por una serie de propiedades y relaciones con otras entidades lo cual para "la bandota" se conoce como modelo del dominio.

Este modelo del dominio nos remite a una práctica dentro de la ingeniería de software llamada diseño dirigido por dominio (domain driven design o DDD), la cual sostiene que el desarrollo de una solución debe estar basada en un modelo generado a partir de conceptos del negocio particular que se quiere abordar así como encapsular la lógica y reglas que dicte el mismo negocio.

Una vez que se tiene un modelo de dominio robusto y probado (donde entra en juego el desarrollo dirgido por pruebas o TDD), solo resta exponer ese dominio como recursos con la acción que aplique para cada caso.

Este modelo del dominio también funciona como un formato homologado de información entre aplicaciones y plataformas, pues independientemente de la tecnología propia de cada solución, las estructuras de datos dictadas por el modelo de dominio pueden ser implementadas puntualmente por cada tecnología, ejemplo.
  • Modelos active record para un backend Ruby on Rails
  • Clases Java para una aplicación Android
  • Clases Swift u Objective C para una aplicación IOs
  • Objetos JSON para intercambio de inforrmación sobre HTTP.
  • Objetos JSON para una aplicación basada en Angular o JQuery
  • Tablas y llaves foráneas para una base de datos relacional
  • Documentos JSON para una base de datos MongoDB o DynamoDB

Anarquía de una tierra sin estado

El protocolo HTTP es por definición sin estado, esto es que una petición guarda un registro de otras peticiones. Esto se extrapola a los servicios ofrecidos por un API REST donde una petición específica no tiene acceso a los datos de peticiones anteriores. 

Una gran ventaja de tener servicios sin estado es la facilidad de crecimiento horizontal que se tiene. Dado la naturaleza sin estado de los servicios es posible generar replicas del servicio y solo utilizar un balanceo de carga para incrementar la capacidad de atención de peticiones.

En un ambiente de nube se puede utilizar el concepto de elasticidad para incrementar o decrementar las réplicas del servicio sin necesidad de mecanismos como la replicación de sesiones.  En el caso de Amazon servicios como Elastic Load Balancer, EC2 y Autoscaling permiten hacer esta magia de forma relativamente sencilla con la opción de agregar otras "monerías" como monitoreo, certificados digitales, replicación en otras regiones, etc.

El Can Cerbero Tokenizado

La seguridad es un tema obligado en cualquier solución tecnológica con el fin de garantizar tanto como sea posible la integridad, confidencialidad y disponibilidad de la información.

El uso de tokens es el mecanismo recurrido para implementar ciertas medidas de seguridad. Para esto pueden distinguirse dos tipos de tokens.
  • API Token. El proveedor de servicios genera un token único por aplicación que pretende utilizar los servicios expuestos a manera de REST API. Dicho token es solicitado y utilizado para verificar la aplicación cliente. Los API's de Facebook, AWS o Google son ejemplos que utilizan este mecanismo. Una forma de implementar esto es a través de un API Gateway el cual puede ser utilizado para agregar medidas adicionales como prevención de ataques de DoS.
  • Access Token o Auth Token. Utilizado para identificar y autenticar una cuenta de usuario de la aplicación. Dado que este mecanismo permite asociar las llamadas a un cliente en particular se vuelve una manera de implementar una sesión de usuario donde el estado conversacional se mantiene en el cliente. 
Dentro de las ventajas del uso de tokens pueden mencionarse:
  • Los tokens pueden ser forzados a expirar como modo de revocar el acceso a un usuario o aplicación.
  • Los tokens son cadenas alfanuméricas únicas generadas por el REST API, lo que robustece la aplicación ante ataques de diccionario, fuerza bruta o ingeniería social.
Cabe mencionar que los REST API suelen ser expuestos mediante HTTP SSL/TSL y los tokens suelen enviarse como cabeceras de cada petición para evitar el secuestro de sesiones o la alteración de la información que viaja hasta el proveedor de servicios.

Cache-ando ando

Mucha información consultada tiene muy pocos cambios a lo largo del tiempo, por lo que almacenarla en un cache local incrementa el rendimiento de las aplicaciones cliente al reducir la cantidad de llamadas remotas al proveedor de servicios.

Se pueden identificar dos niveles de cache
  • Memoria. Mantiene una copia en memoria de los datos recuperados desde la fuente. Se recomienda para cantidades moderadas de datos que son consultados frecuentemente. Ej, catálogos estáticos, información de la cuenta de usuario.
  • Archivos. Genera archivos locales a partir de la información recuperada desde la fuente. Empleado para archivos binarios como imágenes y documentos o grandes cantidades de texto.
Cuando se tiene identificada información que cambia periodicamente puede configurarse el cache para que información específica expire obligando a que sea actualizada desde el origen.

De igual modo es posible manejar diversos caches en diferentes puntos de toda una solución. Si bien se hablaba de un cache local en un cliente (dispositivos móviles o un navegador web), también es posible habilitar bases de datos en memoria (Redis, Memcache, Coherence) donde los REST API puedan almacenar información obtenida de otros repositorios (bases de datos, documentos, etc) y así mejorar los tiempos de respuesta.

La asincronización hace la fuerza

Dado que un REST API expone una serie de servicios remotos, es preferible (y en algunos casos mandatorio) acceder al API de manera asíncrona. De este modo la aplicación cliente puede continuar con su labor o incluso consumir diferentes servicios de manera cuasi simultánea. Por ejemplo mientras se está descargando una foto del portal de Suicide Girls, la aplicación puede estar generando una gráfica, recibiendo una notificación y enviando información de uso.

Aunque tanta magia simultánea requiere un cambio de paradigma en como se desarrollan las aplicaciones cliente, pues ahora el modelo de programación es basado en eventos y notificaciones de cuando una tarea asíncrona es concluida.  

El acceso asíncrono, junto con los esquemas para mejorar la disponibilidad y el poder de cómputo distribuido potencial de las aplicaciones cliente (móviles, web browser, etc) pareciera que nos ván remitiendo a terrenos del manifiesto reactivo. Esto me sugiere que un REST API puede ser un componente de solución para implementar una ansiada arquitectura reactiva (alguna vez Gus me dijo que quería construir una aplicación de este tipo). Pero eso será tema de otra entrada de blog y otro sueño de una noche de insomnio y valkirias.

domingo, 20 de septiembre de 2015

Computo en la nube o de como empieza el reinado de los servicios

Hace más de dos decadas, el autor de este artículo, Gustavo De la Cruz, estudiaba y devoraba la arquitectura de CORBA y marcos de objetos distribuidos similares (COM, SOM y otras decenas de tecnologías similares) con el fin de lograr un esquema de aplicaciones integradas a través de objetos. En esos tiempos los lenguajes Orientados a objetos eran C++, Objective C, Smalltalk, Eiffel y todos prometian una pronta integración entre ellos.  SUN Microsystems tenía un proyecto muy fuerte entre manos para revolucionar el computo distribuido. Estoy hablando de inicios de la decada de los 90.

La arquitectura se basaba en servicios comunes para lograr la persistencia, ciclo de vida, concurrencia, seguridad, eventos, transacciones y un sin fin de servicios que parecía el paraíso de los programadores para hacer aplicaciones distribuidas basadas en objetos. El protocolo unificador era IIOP y parecia que nadie iba a poder igualar esta labor, ni Microsoft con su COM.

En esos tiempos este era mi libro de referencia y lo leía casi todos los días


Y llego Java, y los jovenes proyectos acabaron devorando a los viejos proyectos de CORBA. Aunque al principio Java fue un lenguaje excelente para implementar CORBA, en ese momento también el uso del protocolo HTTP como el gran transportador de mensajes síncronos entre aplicaciones y elevando el nivel de estandarización y la capacidad de exponer objetos no solo en redes privadas, sino via la naciente Internet. Así se unió al modelo multicapa, una capa adicional, de 3 a 4 capas, la capa de Web.

Muchos saben ya la historia, salió J2EE (hoy JEE) y muchos servicios de CORBA vieron su simil, Transacciones y ciclo de vida se volvieron EJBs, Persistencia EJB de entidad, Naming a JNDI y con eso se elevó el nivel de reuso de servicios. Y si, los programadores ya teniamos las herramientas para hacer la magia que tanto soñabamos con objetos. Llegó la epoca del servidor de aplicaciones. Decenas de compañías te ofrecían en el JavaONE su producto, empresas que ya no figuran. Podría decir que los únicos sobrevivientes de esos tiempos que ahora veo con una particular nostalgia de mi epoca de juventud adulta, son WebLogic, Websphere y JBoss, TomCat (es un appserver ??)  donde se pueden edificar arquitecturas de despliegue que pueden usar procesamiento de manera escalable y formando clusters.

En esos tiempos, los que eramos arquitectos de software, con un pequeño nivel de soberbia, no pensabamos tanto en el hardware. Al final, la magia de la portabilidad permitia que el diseño pudiera ejecutarse en cualquier tipo de computadora que soportara la JVM y podiamos confiar que la ingeniería del JIT se podía encargar de ejecutar de manera optima el código...

Esta arquitectura aun es la reina en muchos ambientes de aplicaciones empresariales. Hemos educado a las nuevas generaciones a confiar sin cuestionar la magia de los servidores de aplicaciones. De igual manera, el mundo  Microsoft .NET hizo lo similar y aprovechó las lecciones dolorsamente aprendidas en temas de desempeño para simplificar el modelo de aplicaciones con objetos distribuidos.

Llegó la revolución de la simplificación, 2003, cuando Rod Johnson y varios más cuestionaron el enfoque de utilizar/desperdiciar recursos de computo y volvieron a los Plain Old Java Objects.  Se dieron arquitecturas livianas, corriendo con TomCat y rompiendo la ortodoxia de que todo era un EJB.

Los clusters de Weblogic o Websphere seguían teniendo sentido para aplicaciones que necesitaban de escalabilidad y de manera mágica se hacia la migración y manejo de las fallas, así como unir al cluster una JVM más. Así es el estado de los actuales servidores de aplicaciones y se han optimizado con esquemas de base de datos en memoria o caché (Terracota, Coherence)

La última complicación del lado del mundo Java fueron sus JSF, con el intento de hacer componentes web reutilizables, pero con demasiado énfasis en que todo lo resuelve el servidor.

Y el resurgimiento de Javascript, dado que el navegador ya no es una pieza tonta de software que solo desplegaba HTML e imágenes, sino toda una gama de componentes para visualizar, almacenar, comunicar que ahora es HTML5, CSS3 y Javascript y donde el procesamiento se puede hacer en la computadora cliente que ya tiene capacidades respetables.

Agregado a la aparición de aplicaciones móviles que muchas veces tienen que trabajar fuera de línea; todo ha llevado que los servicios distribuidos tienen una clara definición de que es lo que deben de hacer y estandarizados a través de modelos basados en REST o intercambio con JSON.

Esto ha llevado a una nueva variante de implantar los servicios. Muchos usando software abierto. Modelos de base de datos donde ya no solo es SQL la única opción, distribución de la carga de trabajo usando esquemas de mensajes asíncronos y capacidades para analizar grandes volumenes de datos usando procesamiento distribuido.

El hardware se ha vuelto un "commodity" y los procesadores, almacenamiento y redes se pueden manejar por decenas y abaratando los modelos de computo distribuido e implantar masivamente servicios de software que están reemplazando al modelo de servidores de aplicaciones pero usando directamente las capacidades del hardware "virtualizado".

Como dije, hace un par de decadas no era el hardware el modelo primordial al diseñar la arquitectura, hoy en día es fundamental y la escalabilidad y tolerancia a fallas ya no es tanto de un sistema operativo o de un middleware, sino de mecanismos que permiten replicar imagenes virtuales sobre múltiples procesadores y almacenamiento y con la capacidad de resistir a fallas. Ya nadie queda impactado si un nodo de computo tiene un problema, puede ser reemplazado por uno similar y  en cuestión de segundos o minutos.

Todo esto es lo que se llama computo en la nube. Al final es lo que narro, muchos servicios disponibles con un pool de recursos casi infinito de procesadores, almacenamiento y redes y disponible de manera ubicua a través de Internet.

Nunca he comprobado esta teoria, pero presiento que la manera como se están solucionando los diversos temas relacionados con ofrecer un servicio de la nube viene desde lo aprendido por muchos en sus clases de sistemas operativos o  ambientes distribuidos, de un sistema operativo llamado Amoeba, que nacio de la escuela de Andrew Tanenbaum. El siguiente diagrama muestra la arquitectura y vean que el pool de procesadores es lo que ahora se llama computo elástico. Los invito a leer los libros de Tanenabaum en esta materia y se van a ver sorprendidos que hace 20 años ya las ideas actuales estaban definidas


A lo que voy de toda esta historia es que el momento que estamos viviendo de computo en la nube es el momento de madurez de un tipo de computo que fue concebido como objetos y que se transformo a servicios que son ubicuos, portables, interoperables y con la capacidad de explotar hasta el "tuetano" las capacidades de virtualización de hardware.

Hoy mucha gente está preocupada sobre la nube, que implica.  Puesto de manera simplificada es poner en Internet tus aplicaciones. Ese puede ser el primer foco de usar una nube pero no es el mejor en términos de arquitectura por que es llevarse todo lo que tienes bien y mal en los sistemas empresariales y no usar el total potencial de la tecnología de la nube. Muchos aún se preocupan por subir el servidor de aplicaciones, clusters, la complejidad de un RDBMS en la nube. Como primer paso quizá está bien pero ...

Es importante que los especialistas de TI se abran y entiendan el estado actual del arte de la tecnología. Ya  no hay un solo lenguaje de progamación, ya no hay una plataforma que predomine, la guerra de CPUs (CISC vs RISC) o de sistemas operativos (Windows vs UNIX-Linux)  se acabó y hubo ganadores que ni siquiera pueden ya cantar victoria. 

Lo que se debe aprovechar es la riqueza y variedad potencial de los servicios distribuidos que se ofrecen y usarlos por sus caracteristicas (disponibilidad, confiabilidad, capacidad, seguridad, portabilidad e interoperabilidad) y ya no ponerse en modo ortodoxo si es de un fabricante o una tecnología en particular. En este momento, la visión inicial de los objetos distribuidos como componentes reutilizables (o de re uso) ya es un hecho pero no es el resultado del esfuerzo de un fabricante o grupo (como era DCE o CORBA) sino de la apertura del software abierto y que ha sido adoptado por cuestiones técnicas y no comerciales y se han vuelto estándares de facto.

Asi que si en el servicio existe una arquitectura MEAN o JEE o .NET, o con servicios NoSQL o Hadoop o Spark o RabbitMQ o AMQ, con Windows o Linux; no es preocupante la variedad tecnológica, es bueno dejar la libertad y creatividad a los arquitectos y programadores del software y garantizando los requerimientos técnicos y el nivel de calidad de servicio; y controlar (gobernar) a través de buenas definiciones de arquitectura empresarial y estándares la enorme variedad de tecnologías. 

Pensar entonces como servicios de plataforma es el enfoque, o lo que se conoce como Platform as a Service (PaaS)  es lo que permite explotar el modelo de encapsular la complejidad. 

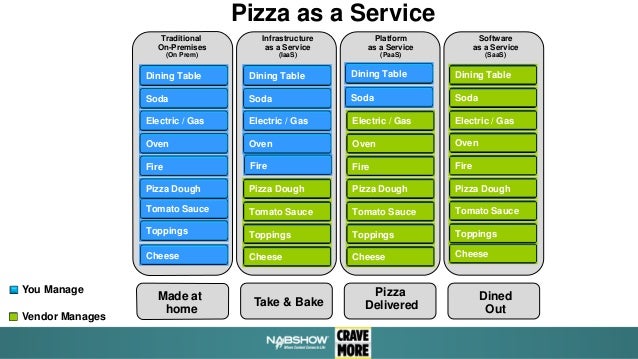
La siguiente presentació de Slideshare, Pizza as a Service,  ayuda a entender el modelo de la nube. Muchos de los lectores ya usan SaaS, dado que tienen una dirección de correo electrónico personal basada en algun servicio (Gmail, Outlook, Yahoo?) 

Empezando a pensar en el futuro. Hoy grandes empresas ofrecen las nubes. Tiene buenos puntos por que podemos delegar la pizza y administrar a través de niveles de servicios. Pero la contraparte es que se sigue concentrando el procesamiento en grandes cúmulos controlados por grandes empresas, lo cual es contrario a la filosofia de Internet.

Voy a repetir (en español) lo que un articulo de SUN sobre JXTA dice al respecto:

"The Internet was founded on a simple vision: to build a highly decentralized and resilient worldwide network infrastructure that would scale and that could resist any denial-of-service attacks" 

"Internet fue creado con una visión simple: constituir una infraestructura de red  de alcance mundial y que es altamente descentralizada y resilente  que puede escalar y resistir cualquier denegación del servicio"

JXTA, que es una tecnología que siento aún no se comprendió, y la última obra de Bill Joy en SUN, tuvo la visión de tomar P2P como el siguiente paso. Yo identifico que en la epoca del IoT, JXTA tiene mucho por decir.

Analizando la arquitectura de JXTA, nos lleva a un nivel adicional de procesamiento. Se construyen redes virtuales de peers encima de la infraestructura estática de la actual Internet. 


Pienso entonces, algún dia también las nubes se van a volver "commodity" y tendremos la libertad de usar nubes públicas abiertas (open cloud computing?) para constituir nuestros servicios personalizados o de una empresa. La nube se va convertir en una red de Peers y que de manera dinámica se van a enlazar. Espero en unos años leer esta entrada y ver que tanto atine a predecir sobre este tema.

Por mientras, si es importante considera el computo en la nube, identificar su beneficio a nivel de negocio, el cual siempre es hacia la agilidad de tener soluciones tecnológicas para lograr innovación y realización de la estrategia. Quien no tome esta oportunidad, va a quedar muy rezagado para el siguiente paso. No teman en cambiar los viejos paradigmas de procesamiento. No mas servidores de aplicaciones, no más grandes clusters, los servicios de la nube ya tienen la capacidad para dar el modelo equivalente.

Quien tenga el valor de hacer este cambio, ya está adelantando buenos pasos. Diria, está innovando ...

Esperando comentarios ...


martes, 11 de agosto de 2015

Ideas para productos ...

Usando el blog para tener la bitácora de como estamos plasmando ideas

De lo que están trabajando Ricardo, Alex y Mike, el actualmente llamado UberCare, que necesito sentarme un rato para ver con ustedes la arquitectura, se me ocurre también empezar a meter del lado backend la parte médica y explorar este software Health GNU y la versión demo que está para Docker y montarla en AWS y también desembuchar mi curso de HL7. Esta liga está interesante IoT HealthCare y me hace pensar en open hardware para IoT Healthcare... Pero necesitamos ir a habler con gente del ramo ... Más que hacernos ricos de manera inmediata por la App, es atraer la atención de consumidores masivos hacia innbit y que tengamos experiencia en el nicho de innovación. Sigo diciendo e insistiendo que el negocio es posiblemente por la información a recopilar.

Y de ahí, la metodología de emprendimiento es nuestro crisol para probar ...

De CoachBit, usar Lego Serious Play como punto de partida para nuestro enfoque de capacitación en TOGAF, PMP, ITIL, SCRUM, CMMI, HL7... Hacer videos y comics como parte de esta nueva idea que puede volar muy lejos ... De nuevo, la pasión por algo se convierte en innovación, lo que no logré hacer en la ULSA cuando fui profesor es realizable y como parte de mi trabajo!!

Y de CloudBit, trabajar fuertemente en ser la figura de integradores de la nube. La manera como están creciendo los servicios de la nube es impresionante y estamos llegando ya a la era donde se está exponiendo por fin componentes de software como servicio. Y tener una plataforma adecuada de administración del ecosistema de nubes

Y veo que el tema de inteligencia de negocio, a veces tan oscuro en ciertas áreas de TI, se puede llevar a una implantación de alto impacto usando tecnologías de nube como AWS o Azure. Empapandome de bibliografia desde Inmon y Kimball y de ciencia de datos; y de un eofuqe interesante de Cutter para agilizar el proceso de implantación y la idea de usar TOGAF y Lego Serious Play de nuevo aparece ...

Y la semana pasada que abuse virtualmente del buen chillicoder, dandole mucha información sobre el tema de software factories, para nuestro primer enfoque de ProduceMe. Como es costumbre nos damos cuenta que ya tenemos nuestra primera definición, usando DDD, BDD y TDD y apoyarnos de Ruby on Rails, justo en el momento en que chillicoder está convirtiendose al bando de Elixir ...

Veo que para lo que resta del 2015 en Innbit tenemos muchos puntos de trabajo.

Al final, para el inicio 2016 nuestra cartera sera fuerte, desde temas de enfoques de innovación, arquitectura empresarial, LSP, cloud computing, ciencia de datos y con logros interesantes.

Lo que siempre es bueno, es persistir en ideas, y agregar variantes.